Capitulo 16
Proyecto final: pipeline completo de Ciencia de Datos
Integra la pregunta de negocio, los datos, la evaluación y la comunicación en un repositorio reproducible
Guía de proyecto final para consolidar un flujo verificable: pregunta, adquisición, contratos, SQL/ETL, exploración, visualización, modelo o análisis, evaluación, pruebas, documentación y defensa de límites.
Un pipeline completo es reproducible, verificable y útil para una pregunta concreta. Un notebook largo, un modelo complejo o muchas gráficas no compensan un target ambiguo, una fuga temporal o una conclusión que el diseño no puede sostener.
Cada transformación debe tener un motivo, una prueba y un lugar claro en el flujo.
— Regla del proyecto final
16.1 Objetivo y alcance
El proyecto final corresponde al Módulo 17 del PDF y consolida el recorrido de Data Science II. Elige una pregunta de clasificación, regresión o análisis descriptivo con una fuente accesible y una unidad de observación clara. El alcance debe caber en un repositorio reproducible y permitir explicar las decisiones.
Una propuesta inicial podría ser:
«Con datos de clientes observados hasta el cierre mensual, evaluar si un modelo identifica cancelaciones en los próximos 30 días mejor que un baseline, y estimar el costo de las alertas falsas bajo una capacidad de contacto limitada».
No es suficiente decir «hacer churn» o «predecir ventas»: especifica población, unidad, horizonte, target, decisión, baseline y métrica.
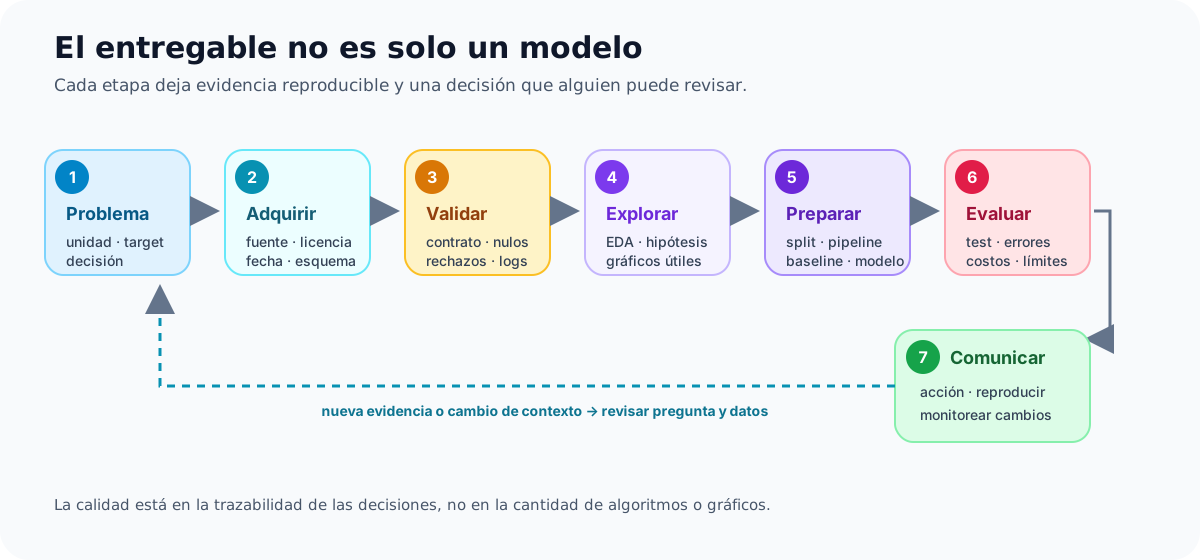
16.2 El ciclo de entrega
| Etapa | Pregunta | Evidencia en el repositorio |
|---|---|---|
| 1. Definición | ¿Qué decisión mejora y para quién? | README: alcance, población, target, horizonte y métrica |
| 2. Adquisición | ¿De dónde vienen los datos y qué licencia/limitaciones tienen? | Código reproducible, fuente, fecha, esquema y configuración |
| 3. Calidad | ¿Qué filas, tipos, faltantes y rangos deben controlarse? | Contrato, validaciones, reporte de rechazos y pruebas |
| 4. Preparación | ¿Qué transformaciones se requieren y cuándo se ajustan? | ETL modular y pipeline de preprocesamiento |
| 5. Exploración | ¿Qué distribuciones y relaciones guían decisiones? | Notebook/script con EDA útil, no una colección de gráficos |
| 6. Modelado o análisis | ¿Qué baseline y candidato responden la pregunta? | Entrenamiento reproducible y parámetros versionados |
| 7. Evaluación | ¿Generaliza según el proceso real de uso? | Split apropiado, métricas, matriz/errores y límites |
| 8. Comunicación | ¿Qué se recomienda y qué no sabemos? | Visualización, resumen ejecutivo y riesgos |
| 9. Reproducción | ¿Otra persona puede ejecutar y verificarlo? | Entorno, comandos, tests, artefactos regenerables y Git limpio |
16.3 Estructura sugerida del repositorio
proyecto-final/
├── README.md                  # pregunta, resultados, límites y cómo ejecutar
├── pyproject.toml             # dependencias y configuración, o requirements.txt
├── .env.example               # nombres de variables; sin secretos reales
├── .gitignore
├── data/
│   ├── README.md              # origen/licencia; no incluir PII o archivos pesados
│   └── sample/                # muestra sintética pequeña para pruebas
├── notebooks/
│   └── 01_eda.ipynb           # exploración; lógica reusable vive en src/
├── sql/                       # consultas analíticas si aplica
├── src/
│   ├── extract.py
│   ├── transform.py
│   ├── train.py
│   └── evaluate.py
├── tests/
│   ├── test_data_contract.py
│   └── test_pipeline.py
└── reports/
    └── figures/               # gráficas generadas; incluir solo resultados necesarios
No subas credenciales, datos personales innecesarios, entornos virtuales ni binarios grandes de modelo. Si el dataset no puede compartirse, documenta cómo conseguirlo y ofrece una muestra sintética que permita ejecutar las pruebas.
16.4 Construir el baseline antes del candidato
El baseline es una comparación mínima que muestra cuánto aporta el modelo. Para clasificación puede ser la clase mayoritaria o una regla de negocio; para regresión, la media/mediana de train o una regla temporal. No uses el valor objetivo del test para construirlo.
import pandas as pd
from sklearn.compose import ColumnTransformer
from sklearn.dummy import DummyClassifier
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import OneHotEncoder, StandardScaler
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.linear_model import LogisticRegression

# Ejemplo de clasificación con Telco Customer Churn; ajusta la ruta a tu copia autorizada.
df = pd.read_csv("data/WA_Fn-UseC_-Telco-Customer-Churn.csv")
df["TotalCharges"] = pd.to_numeric(df["TotalCharges"], errors="coerce")
y = df["Churn"].map({"No": 0, "Yes": 1})
X = df.drop(columns=["customerID", "Churn"])

numeric_features = ["tenure", "MonthlyCharges", "TotalCharges", "SeniorCitizen"]
categorical_features = [column for column in X if column not in numeric_features]
preprocessor = ColumnTransformer([
    ("numeric", Pipeline([
        ("imputer", SimpleImputer(strategy="median", add_indicator=True)),
        ("scaler", StandardScaler()),
    ]), numeric_features),
    ("categorical", Pipeline([
        ("imputer", SimpleImputer(strategy="most_frequent")),
        ("one_hot", OneHotEncoder(handle_unknown="ignore")),
    ]), categorical_features),
])

# Ejemplo i.i.d. de clasificación. Series temporales/grupos requieren otro split.
X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.20,
    random_state=42,
    stratify=y,
)

baseline = DummyClassifier(strategy="prior")
candidate = Pipeline([
    ("preprocessing", preprocessor),
    ("model", LogisticRegression(class_weight="balanced", max_iter=2000)),
])

baseline.fit(X_train, y_train)
candidate.fit(X_train, y_train)
En una serie temporal, este split aleatorio no es válido: corta cronológicamente y entrena solo con pasado. Si hay varias filas por persona, hospital, tienda u otra entidad, considera un split por grupo para impedir que la misma entidad aparezca en train y test.
16.5 Evaluar sin fuga y reportar errores
La búsqueda de hiperparámetros, la selección de features y el ajuste de umbral se hacen en train/validación o dentro de validación cruzada. El test queda reservado para una evaluación final según un protocolo definido.
from sklearn.metrics import classification_report, confusion_matrix, roc_auc_score

candidate.fit(X_train, y_train)
test_probability = candidate.predict_proba(X_test)[:, 1]
threshold = 0.40  # elegir previamente en validación según costo/capacidad
test_prediction = (test_probability >= threshold).astype(int)

print(confusion_matrix(y_test, test_prediction))
print(classification_report(y_test, test_prediction, zero_division=0))
print("ROC-AUC:", roc_auc_score(y_test, test_probability))
El umbral del ejemplo solo ilustra dónde se aplica una regla previamente escogida; no lo selecciones mirando el resultado del test. Acompaña las métricas con una matriz de confusión, casos de error representativos sin información sensible, comparación con baseline, estrategia de split y limitaciones.
Para un modelo de regresión cambia el objetivo y reporta métricas como MAE/RMSE con unidades; compara con baseline y grafica residuales. Para una pregunta descriptiva sin modelo predictivo, presenta definición de población, filtros, estimaciones y una incertidumbre compatible con el diseño.
16.6 Persistir el pipeline completo y probarlo
Al serializar un modelo supervisado, guarda el preprocesamiento junto con el estimador. Versiona el código y los parámetros; documenta compatibilidad de versiones, origen y fecha de entrenamiento. Carga artefactos solo desde fuentes confiables: los formatos basados en pickle/joblib pueden ejecutar código al deserializar.
from pathlib import Path
import joblib

artifact_path = Path("artifacts/churn_pipeline.joblib")
artifact_path.parent.mkdir(parents=True, exist_ok=True)
joblib.dump(candidate, artifact_path)

loaded = joblib.load(artifact_path)
assert loaded.predict(X_test.iloc[:3]).shape == (3,)
Pruebas mínimas:
- La extracción entrega columnas obligatorias y tipos esperados.
- Las reglas de duplicados y nulos son explícitas.
- El pipeline acepta una fila nueva y rechaza una entrada incompatible con error claro.
- Se puede ejecutar desde una carpeta limpia siguiendo el README.
- El pipeline guardado carga y predice con las mismas columnas.
- La partición, métrica y resultado principal se pueden reproducir con semillas/documentación.
Las pruebas no validan utilidad de negocio, equidad ni calidad de los supuestos. Son evidencia de funcionamiento, no garantía universal.
16.7 Resumen ejecutivo: decisión, evidencia y límite
Una defensa breve puede responder:
- ¿Qué problema y decisión abordó el proyecto?
- ¿Qué representa una fila, cuál es el target y en qué horizonte?
- ¿Qué fuente, controles de calidad y restricciones aplicó?
- ¿Qué baseline comparó y por qué eligió el modelo/método?
- ¿Qué resultado obtuvo en evaluación no vista y cómo se compara?
- ¿Qué errores importan más, qué recomienda y cuánto costaría actuar?
- ¿Qué limitaciones, sesgos, riesgos de privacidad o supuestos siguen abiertos?
Una conclusión sólida puede ser «no hay evidencia suficiente para automatizar; proponemos un piloto medido», no necesariamente «el modelo está listo». Si el análisis es observacional, no presentes una asociación como intervención causal.
16.8 Rúbrica de autoevaluación
| Área | Pregunta de aceptación |
|---|---|
| Problema | ¿Target, unidad, horizonte, población y métrica se entienden sin explicación oral? |
| Datos | ¿Fuente, licencia, calidad, fechas, privacidad y limitaciones están documentadas? |
| Método | ¿Baseline y transformaciones corresponden al diseño y evitan leakage? |
| Evaluación | ¿El split refleja el uso, el test se reservó y los errores se interpretan con costos? |
| Comunicación | ¿Gráficos, tablas y recomendación responden a la decisión y muestran contexto? |
| Reproducibilidad | ¿README, entorno, pruebas, semillas y pasos permiten volver a ejecutar? |
| Ética y seguridad | ¿Minimiza datos sensibles, registra límites y evita acciones no justificadas? |
Reproducibilidad
M16Capacidad de ejecutar de nuevo un análisis con datos, código, dependencias y parámetros identificados para obtener resultados verificables dentro de límites documentados.
Ej: Un README indica cómo obtener el CSV permitido, crear el entorno, ejecutar tests y regenerar métricas y figuras sin rutas locales ni secretos.
Elige un proyecto de módulos anteriores y conviértelo en repositorio reproducible. Un compañero debe poder instalarlo y ejecutar las pruebas solo con el README. Luego prepara una exposición de cinco minutos: pregunta, flujo, baseline, resultado, error relevante, recomendación, límite y siguiente experimento. Si no puedes señalar el archivo que respalda cada afirmación, añade evidencia o retira la afirmación.
💡 La selección del sistema también puede memorizar el test.
Q: ¿Qué harías si el baseline iguala o supera al modelo?
Verificaría el pipeline, el split y la métrica; revisaría si existe leakage o falta información; compararía costos y estabilidad. Si el modelo no añade valor medible, no recomendaría su complejidad y reformularía la pregunta o recopilaría mejor evidencia.
🪤 Aumentar complejidad o buscar otra métrica hasta que el modelo parezca ganador.Cierre del recorrido
Completaste la secuencia desde la pregunta, las fuentes y las tablas hasta la evaluación, la visualización, la asociación estadística y la comunicación. En un proyecto profesional el ciclo no termina con la entrega: vuelve a empezar cuando cambia la población, la fuente, la decisión o el costo de los errores.
Tu espacio de estudio
Notas privadas
Se guardan solo en este navegador y no se publican.