Capitulo 08
Persistencia y automatización de datos
SQLAlchemy 2.0, contratos de datos y ETL seguro de extremo a extremo
Modela tablas como clases, administra transacciones con SQLAlchemy 2.0 y construye un ETL validado, seguro e idempotente. Incluye contratos con Pydantic, áreas staging, mínimo privilegio, hooks y la guía de la pre-entrega.
Correspondencia curricular: este capítulo DSBook M8 reúne el contenido del Módulo 9 del PDF, «Automatización y Patrones de Datos».
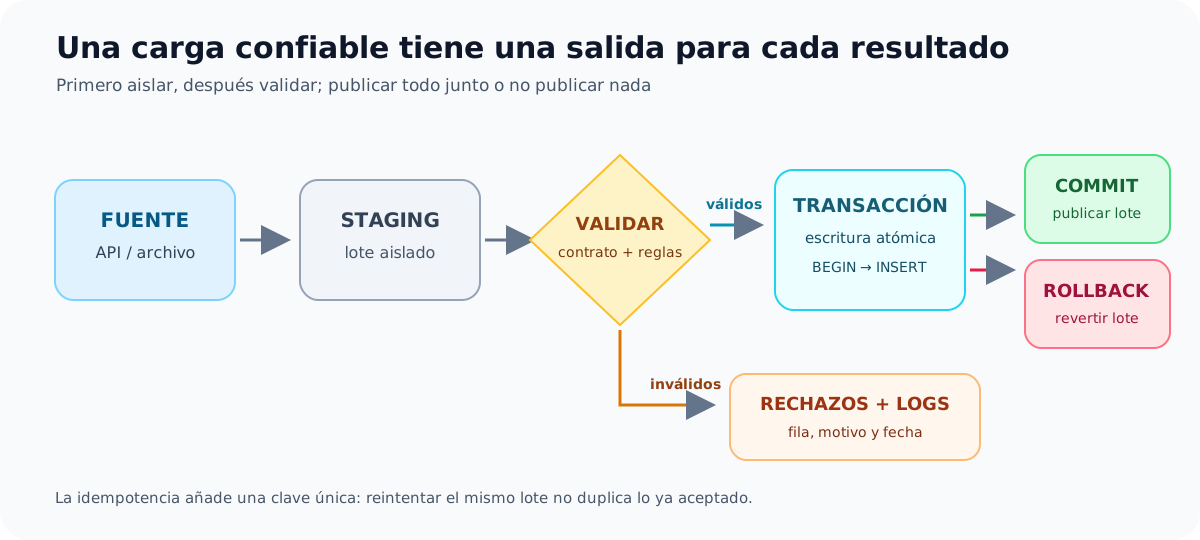
Un ETL confiable comprueba el dato antes de aceptarlo, limita el daño que puede causar una falla y permite repetir la ejecución sin duplicar resultados. SQLAlchemy aporta la capa de persistencia; los contratos, las transacciones y los logs hacen que el flujo sea defendible.
Valida en la entrada, escribe dentro de una transacción y conserva evidencia de lo que se aceptó y de lo que se rechazó.
— Regla de un pipeline seguro
8.1 Mapa de aprendizaje
Al terminar el capítulo podrás:
- Explicar cómo un ORM traduce clases y atributos a tablas y columnas.
- Definir modelos con el estilo tipado de SQLAlchemy 2.0.
- Usar un
Enginey unaSessionpara consultar y persistir datos. - Diseñar un ETL con validación, zona de staging, permisos mínimos y tratamiento de errores.
- Hacer que una carga sea transaccional e idempotente.
- Diferenciar hooks de Git, webhooks, triggers de SQL y automatizaciones de CI/CD.
- Preparar un repositorio reproducible para la pre-entrega de persistencia.
💡 No confíes únicamente en la fuente ni en el código que transforma.
8.2 ORM: trabajar con objetos y tablas
Hasta ahora usaste SQL para consultar y modificar tablas. En una aplicación Python, mantener SQL como cadenas y convertir cada fila a mano puede ser repetitivo y frágil cuando cambia un esquema.
Un ORM (Object-Relational Mapping) es el traductor entre el modelo relacional y los objetos de Python:
| Relacional | Python con ORM |
|---|---|
| Tabla | Clase |
| Fila | Instancia u objeto |
| Columna | Atributo |
Clave foránea / JOIN | Relación entre objetos |
SQLAlchemy combina un ORM con herramientas para expresar SQL. El estilo 2.0 usa anotaciones de tipos y mapped_column() para que el modelo sea explícito y más fácil de revisar.
Crear la base declarativa
La clase base reúne los metadatos de los modelos. A partir de ella, SQLAlchemy conoce qué tablas se han definido.
from datetime import datetime

from sqlalchemy import DateTime, Float, String
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column


class Base(DeclarativeBase):
    pass


class WeatherRecord(Base):
    __tablename__ = "weather_records"

    id: Mapped[int] = mapped_column(primary_key=True)
    source_id: Mapped[str] = mapped_column(String(80), unique=True, index=True)
    city: Mapped[str] = mapped_column(String(100))
    temperature_c: Mapped[float] = mapped_column(Float)
observed_at: Mapped[datetime] = mapped_column(DateTime)__tablename__nombra la tabla en la base de datos.Mapped[int]declara el tipo del atributo y participa en el mapeo.mapped_column()especifica el tipo SQL y las restricciones.primary_key=Trueidentifica cada fila; todo modelo necesita una clave primaria.unique=Trueimpide quesource_idse repita en la base; sirve como clave de negocio para la carga idempotente.
El tipo de Python describe cómo se usa el valor en memoria; el tipo de SQLAlchemy define cómo se representa en la base.
| Python | SQLAlchemy | SQL habitual |
|---|---|---|
int | Integer | INTEGER |
str | String / Text | VARCHAR / TEXT |
float | Float | FLOAT |
bool | Boolean | BOOLEAN |
datetime | DateTime | TIMESTAMP |
Que una columna sea Float no garantiza que una temperatura sea razonable. Los tipos, las restricciones de esquema y las validaciones de dominio cubren problemas distintos y se complementan.
Crear las tablas del ejemplo
from sqlalchemy import create_engine

engine = create_engine("sqlite:///data/warehouse.db")
Base.metadata.create_all(engine)
create_all() crea las tablas que aún no existen según los modelos registrados. Es útil en ejercicios pequeños; no reemplaza un proceso de migraciones cuando el esquema evoluciona en un sistema compartido.
8.3 Engine, Session y transacciones
El Engine conoce el dialecto de la base de datos y administra conexiones. Se crea una vez para la aplicación.
La Session representa una unidad de trabajo: reúne lecturas y cambios que deben confirmarse o descartarse juntos.
from sqlalchemy import select
from sqlalchemy.orm import Session

# Insertar dentro de una transacción.
with Session(engine) as session:
    with session.begin():
        session.add(
            WeatherRecord(
                source_id="api-2026-10-01-001",
                city="Santiago",
                temperature_c=22.5,
                observed_at=datetime(2026, 10, 1, 12, 0),
            )
        )

# Consultar con la sintaxis 2.0 basada en select().
with Session(engine) as session:
    statement = select(WeatherRecord).where(WeatherRecord.city == "Santiago")
    records = session.scalars(statement).all()
Al salir normalmente de session.begin(), la transacción se confirma; si ocurre una excepción, se revierte. El with Session(engine) cierra la sesión y libera sus recursos. Cerrar una sesión, por sí solo, no significa que los cambios se hayan confirmado.
Para actualizar un objeto, se consulta, se modifica el atributo y se confirma la transacción. SQLAlchemy detecta el cambio. Para insertar, consultar y actualizar de forma segura:
- Abre una sesión por unidad de trabajo.
- Agrupa cambios que deben ser atómicos en una transacción.
- Confirma solo cuando la unidad terminó correctamente.
- Ante un error, revierte la transacción y registra el contexto necesario para investigarlo.
Transacción
M8Unidad de trabajo que agrupa operaciones de base de datos para confirmarlas juntas o revertirlas si algo falla.
Ej: Insertar las lecturas validadas de un lote: o queda persistido el lote completo, o no queda ninguna fila parcial.
8.4 Diseñar un ETL seguro
Un ETL es un puente entre sistemas y debe tratar la entrada como no confiable, aunque ayer haya funcionado.
Separar staging de producción
Evita copiar datos externos directamente a la tabla final. Usa una zona de transición (staging area) para aislar, revisar y limpiar el lote antes de promoverlo.
| Etapa | Acción | Resultado esperado |
|---|---|---|
| Extracción | Leer una API, archivo o base de origen | Lote crudo con origen y fecha de captura identificables |
| Staging | Guardar temporalmente fuera de la tabla final | Datos aislados para inspección y reintento |
| Validación | Comprobar estructura, tipos y reglas de dominio | Registros válidos y rechazos con motivo |
| Transformación | Normalizar, limpiar y calcular campos derivados | Dataset con el contrato de destino |
| Carga | Escribir en una transacción | Estado final consistente y repetible |
Los datos en tránsito viajan entre sistemas y deben protegerse con TLS/HTTPS. Los datos en reposo viven en archivos o bases y necesitan controles de acceso y protección del almacenamiento.
Aplicar mínimo privilegio
Un proceso ETL no debería conectarse como administrador. Asigna a cada identidad solo los permisos que necesita.
| Componente | Permisos mínimos orientativos |
|---|---|
| Extractor | Lectura (SELECT) en la fuente |
| Transformador | Lectura y escritura en tablas temporales de staging |
| Cargador | INSERT / UPDATE en las tablas de destino necesarias |
Separar credenciales limita el daño posible ante un error o una filtración. Los secretos van en variables de entorno o un gestor de secretos, nunca hardcodeados en el código ni versionados en Git.
8.5 Validar el esquema antes de persistir
Un esquema es el contrato de los datos: define tipos, campos obligatorios y restricciones. Si un modelo espera un número y una API empieza a enviar el texto “Consultar precio”, el proceso debe detectarlo antes de entrenar o cargar datos contaminados.
Validar con Pydantic
Pydantic permite expresar el contrato con clases de Python y obtener errores de validación claros.
from datetime import datetime

from pydantic import BaseModel, ConfigDict, Field, ValidationError


class WeatherInput(BaseModel):
    model_config = ConfigDict(extra="forbid")

    source_id: str = Field(min_length=1, max_length=80)
    city: str = Field(min_length=1, max_length=100)
    temperature_c: float = Field(ge=-90, le=60)
    observed_at: datetime


try:
    reading = WeatherInput.model_validate(api_payload)
except ValidationError as error:
    # Registrar el motivo sin exponer PII ni secretos.
    print(error.errors())
Los límites del ejemplo son ilustrativos: ajústalos al contrato real de la fuente y al dominio. extra="forbid" ayuda a detectar campos inesperados en vez de ignorarlos silenciosamente.
Alternativa: JSON Schema
JSON Schema resulta práctico cuando el contrato debe compartirse con otros lenguajes o declararse como JSON.
{
  "type": "object",
  "properties": {
    "id": {"type": "integer"},
    "email": {"type": "string", "format": "email"},
    "score": {"type": "number", "minimum": 0}
  },
  "required": ["id", "email"],
  "additionalProperties": false
}
Proteger datos personales
Los nombres, correos y direcciones pueden identificar a una persona. En el pipeline:
- Enmascara campos cuando el proceso no necesita el valor completo.
- Separa o seudonimiza identificadores para analizar relaciones sin exponer identidad.
- Limita acceso y retención de los datos personales.
- Evita PII y secretos en logs; registra IDs técnicos y el motivo del rechazo siempre que sea suficiente.
- Protege los archivos locales con
.gitignorey controles de acceso.
Fallo rápido, allow-list y auditoría
- Fail-fast: si el esquema crítico cambió, detén el lote antes de continuar con resultados dudosos.
- Allow-list: enumera las columnas que necesitas; no uses
SELECT *en un ETL estable. - Registro de rechazos: guarda número de fila o clave técnica, etapa y error; no descartes registros en silencio.
- Política de lote: decide si un registro inválido cancela todo el lote o se aísla para revisión. La decisión debe quedar documentada.
8.6 Construir una carga repetible e idempotente
La carga debe poder repetirse sin crear duplicados. Una protección robusta usa dos capas:
- Una clave de negocio estable (por ejemplo,
source_id) con restricciónUNIQUEen la base. - Una operación upsert: inserta si la clave no existe y actualiza si ya está presente.
El siguiente ejemplo usa el upsert específico de SQLite. La API es propia del dialecto; PostgreSQL y otros motores ofrecen variantes equivalentes.
from sqlalchemy.dialects.sqlite import insert as sqlite_insert
from sqlalchemy.orm import Session

valid_records = [item.model_dump() for item in validated_readings]

if valid_records:
    statement = sqlite_insert(WeatherRecord).values(valid_records)
    statement = statement.on_conflict_do_update(
        index_elements=[WeatherRecord.source_id],
        set_={
            "city": statement.excluded.city,
            "temperature_c": statement.excluded.temperature_c,
            "observed_at": statement.excluded.observed_at,
        },
    )

    with Session(engine) as session:
        with session.begin():
            session.execute(statement)
Antes de ejecutar un upsert por lote, asegúrate de que el propio lote no contenga varias versiones ambiguas de la misma clave. Si el origen puede hacerlo, define una regla explícita para detectar o resolver esa colisión.
La validación sucede antes de abrir la transacción: así los registros rechazados no contaminan la tabla. La transacción protege el conjunto que se acepta y la clave única protege contra duplicados incluso si se repite la ejecución.
Trazabilidad mínima del proceso
Cada ejecución debería permitir responder:
| Pregunta | Evidencia útil |
|---|---|
| ¿Qué fuente se leyó? | Ruta o endpoint sin credenciales, fecha y versión/corte |
| ¿Cuánto llegó y cuánto pasó? | Conteos extraídos, válidos, rechazados y cargados |
| ¿Qué cambió? | Resumen de transformación y versión del esquema |
| ¿Qué falló? | Etapa, mensaje y clave técnica del registro |
| ¿Se puede repetir? | Parámetros de ejecución y estrategia anti-duplicados |
Un pipeline idempotente acepta ser ejecutado de nuevo con la misma entrada y produce el mismo estado final. INSERT sin clave única ni estrategia de conflicto no ofrece esa garantía.
8.7 Automatización, patrones y hooks
La automatización ejecuta tareas sin intervención manual continua. Los patrones son las reglas que indican cuándo actuar y qué hacer; automatizar sin entender los patrones puede acelerar el caos.
| Patrón | Ejemplo de regla |
|---|---|
| Texto | Si un mensaje contiene “Reembolso”, asignar prioridad alta. |
| Temporal | Cada viernes, generar el respaldo semanal. |
| Evento / umbral | Si la temperatura supera 80 °C, emitir una alerta. |
| Negocio | Si el inventario cae bajo el mínimo, notificar al proveedor. |
Una regla fija es automatización determinística; no es automáticamente inteligencia artificial. La IA intenta aprender patrones cuando no basta con escribir reglas explícitas. En ambos casos, las personas siguen definiendo objetivos, revisando consecuencias y atendiendo excepciones.
Hooks: intervenir en el momento correcto
Un hook permite ejecutar validaciones o tareas cuando ocurre un evento, sin repetir manualmente esa lógica en cada paso.
| Mecanismo | Evento que lo activa | Ejemplo en datos |
|---|---|---|
Git hook (pre-commit) | Antes de crear un commit | Rechazar cambios si falta una columna requerida en un archivo de muestra. |
| Webhook | Un sistema emisor detecta un evento | Avisar a una URL cuando llega un nuevo registro. |
| Trigger de SQL | INSERT o UPDATE dentro de la base | Registrar un cambio en una tabla de auditoría. |
| CI/CD (p. ej. GitHub Actions) | push, pull request o agenda | Ejecutar pruebas, controles de esquema o actualizar un reporte. |
Un webhook es una notificación HTTP iniciada por el evento del emisor; una API tradicional suele ser consultada por el cliente cuando necesita datos. Un trigger vive en la base de datos; un Git hook o una acción de CI/CD responde a eventos del flujo de desarrollo.
Hacer la automatización resistente
- Valida antes de propagar el dato.
- Busca campos por nombre, no por posiciones frágiles como “columna B”.
- Registra inicio, conteos, resultado y errores por etapa.
- Define reintentos para fallos temporales y evita reintentar errores de contrato sin corregir la causa.
- Deja una ruta de alerta o intervención humana cuando una dependencia no está disponible.
8.8 Pre-entrega: persistencia e integración de scripts ETL
Objetivo
Automatizar la persistencia de datos desde un origen transaccional hacia una base analítica local. El flujo debe ser repetible, estar documentado y mostrar extracción, transformación básica y carga.
Entregables
- Repositorio con un script de automatización en Python o SQL.
- Conexión a una fuente local o remota.
- Limpieza o agregación básica.
- Esquema/DDL de una tabla de destino en SQLite o MySQL.
- Carga que gestione errores comunes de conexión y evite duplicados.
README.mdcon requisitos, configuración, patrón usado y pasos para ejecutar..gitignoreadecuado y commits incrementales, descriptivos.
Criterios de aceptación
- El script ejecuta la carga sin errores de sintaxis.
- El README permite reproducir la ejecución sin explicaciones externas.
- La tabla de destino se define mediante SQL o código.
- La estrategia anti-duplicados está implementada (por ejemplo, clave única y upsert,
IF NOT EXISTSo limpieza explícita). - Los errores no quedan ocultos; el proceso los informa con contexto útil.
- No se incluyen contraseñas, bases locales sensibles ni datos personales innecesarios en el repositorio.
Rúbrica
| Criterio | Peso |
|---|---|
| Funcionalidad del ETL: conexión, extracción, transformación y carga coherentes | 35 % |
| Diseño de persistencia y esquema de datos | 20 % |
| Automatización, manejo de errores y reproducibilidad | 25 % |
| Estructura del repositorio y prácticas básicas | 12 % |
| Documentación y guía de ejecución | 8 % |
| Total | 100 % |
Puntaje de aprobación: 70 puntos.
Elige un CSV pequeño o una fuente propia. Define una clave estable, carga los datos a SQLite con SQLAlchemy, valida tipos y campos requeridos antes de persistir, guarda los registros rechazados con su motivo y ejecuta el proceso dos veces. Compara conteos antes y después: la segunda ejecución debe actualizar o conservar el mismo estado sin duplicar filas. Documenta cómo lo comprobaste.
8.9 Autoevaluación y recursos
💡 Uno administra la comunicación; la otra agrupa una unidad de trabajo.
💡 Piensa en cambios inesperados del origen.
Q: ¿Cómo harías que un ETL fuera seguro e idempotente?
Validaría el esquema y las reglas de dominio antes de cargar; separaría staging; usaría permisos mínimos, una transacción y una clave de negocio única con upsert; registraría conteos y rechazos sin exponer secretos ni PII.
🪤 Decir solamente que agregaría un try/except o que borraría toda la tabla antes de cada ejecución.Para continuar
Una capa de persistencia confiable permite que los datos limpios sobrevivan a la ejecución del script y estén disponibles para otros análisis. El siguiente paso es automatizar las validaciones y la ejecución del pipeline como parte del ciclo de desarrollo, sin perder control sobre los cambios ni sobre la calidad de los datos.
Tu espacio de estudio
Notas privadas
Se guardan solo en este navegador y no se publican.